macOS后台进程调度陷阱:一行plist配置让我的服务慢了6倍
同一套 Python 图像算法,在我的 Mac mini M3 上跑完一次完整流程要 15 秒。部署到一台最普通的云端 4核CPU 实例上,实测 2.6 秒。这你敢信?AI 的错误预判,让这个问题困扰了我好几天,最后揪出来的,是 launchd 配置文件里一个几乎没人注意的参数。 今天把排查过程分享出来,也留作纪念。
一、起点:AI 断言上云会变慢
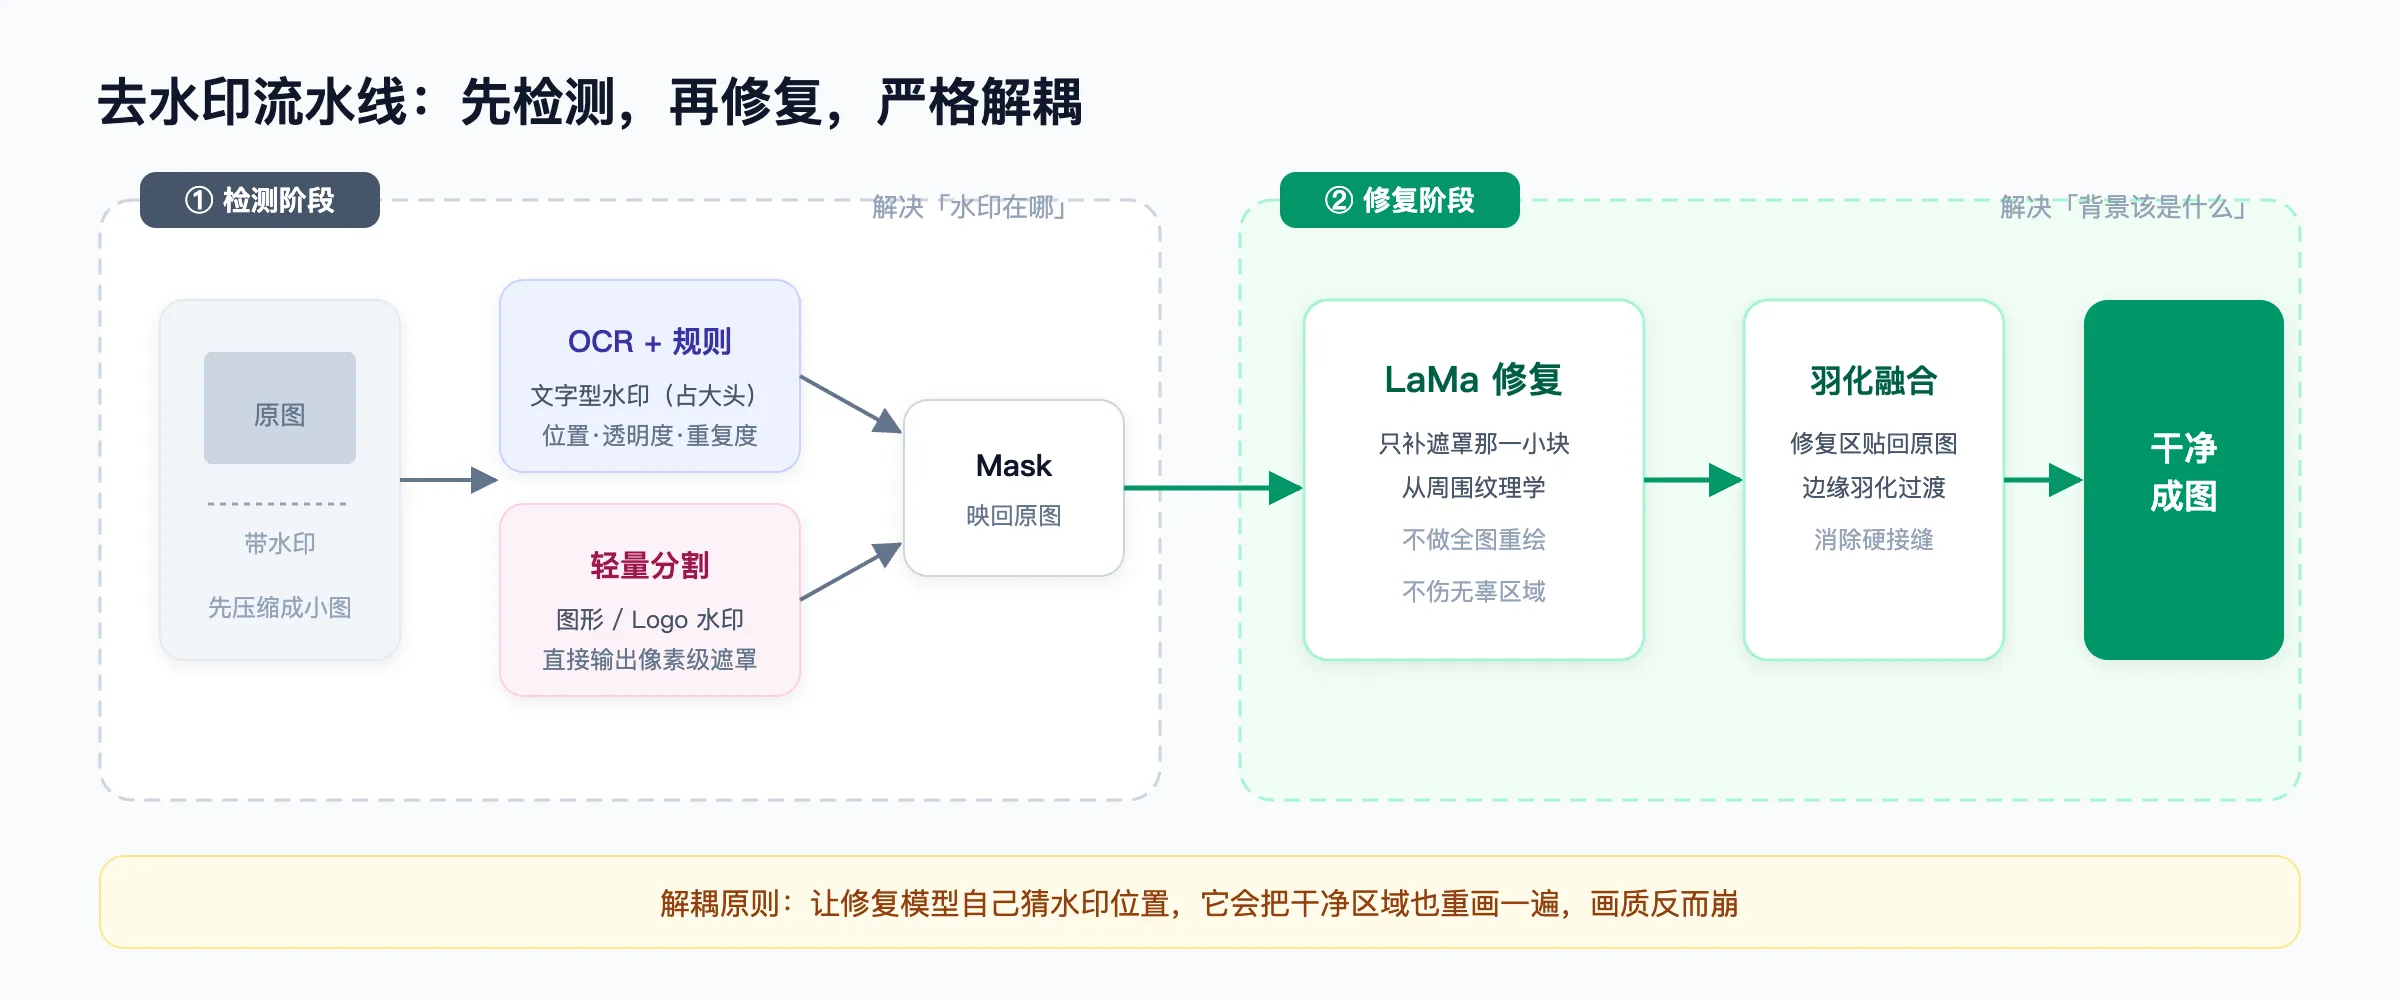
背景交代两句。我有个跑在 Mac mini 上的去除图像水印的算法服务,包含检测、识别和修复模型,本地跑完一次完整流程 15 秒以上。为了对外提供服务,我打算把它部署到云主机,动手前先让 AI 做了一次性能预判。
AI给的分析看起来很专业:深度学习的卷积和推理依赖矩阵运算,云端虚拟机通常没有 GPU,纯 CPU 算力下计算延迟会明显增加,预计跑完一次流程要 20 秒以上。
结果呢,同一套代码部署上去,实测处理时间 2.6 到 3 秒。预判和现实差了 7 倍,方向完全反了。
复盘下来,原因有两个:
一是实际用到的 Inpainting 和 OCR 模型参数量并不大,ONNX Runtime 和 PyTorch 在 CPU 上多线程一开,吞吐比多数人想的好。
二是模型的常识里「深度学习推理必须靠 GPU」的印象太深,轻量模型在 CPU 上的优化空间一直被低估。
所以,老铁们,AI 的性能预判只能当假设,真要拿它做决定,先实测。
二、真正的悬案:本地为什么慢 6 倍
云端快成这样,真正的疑问反而变成了:那 Mac mini 本地的 20 秒是怎么回事?
同样一批模型,云端入门级 CPU 都能 3 秒跑完,M 系列芯片怎么会慢 6 倍。带着这个问题,我把算法流水线拆开,一段一段单独计时。
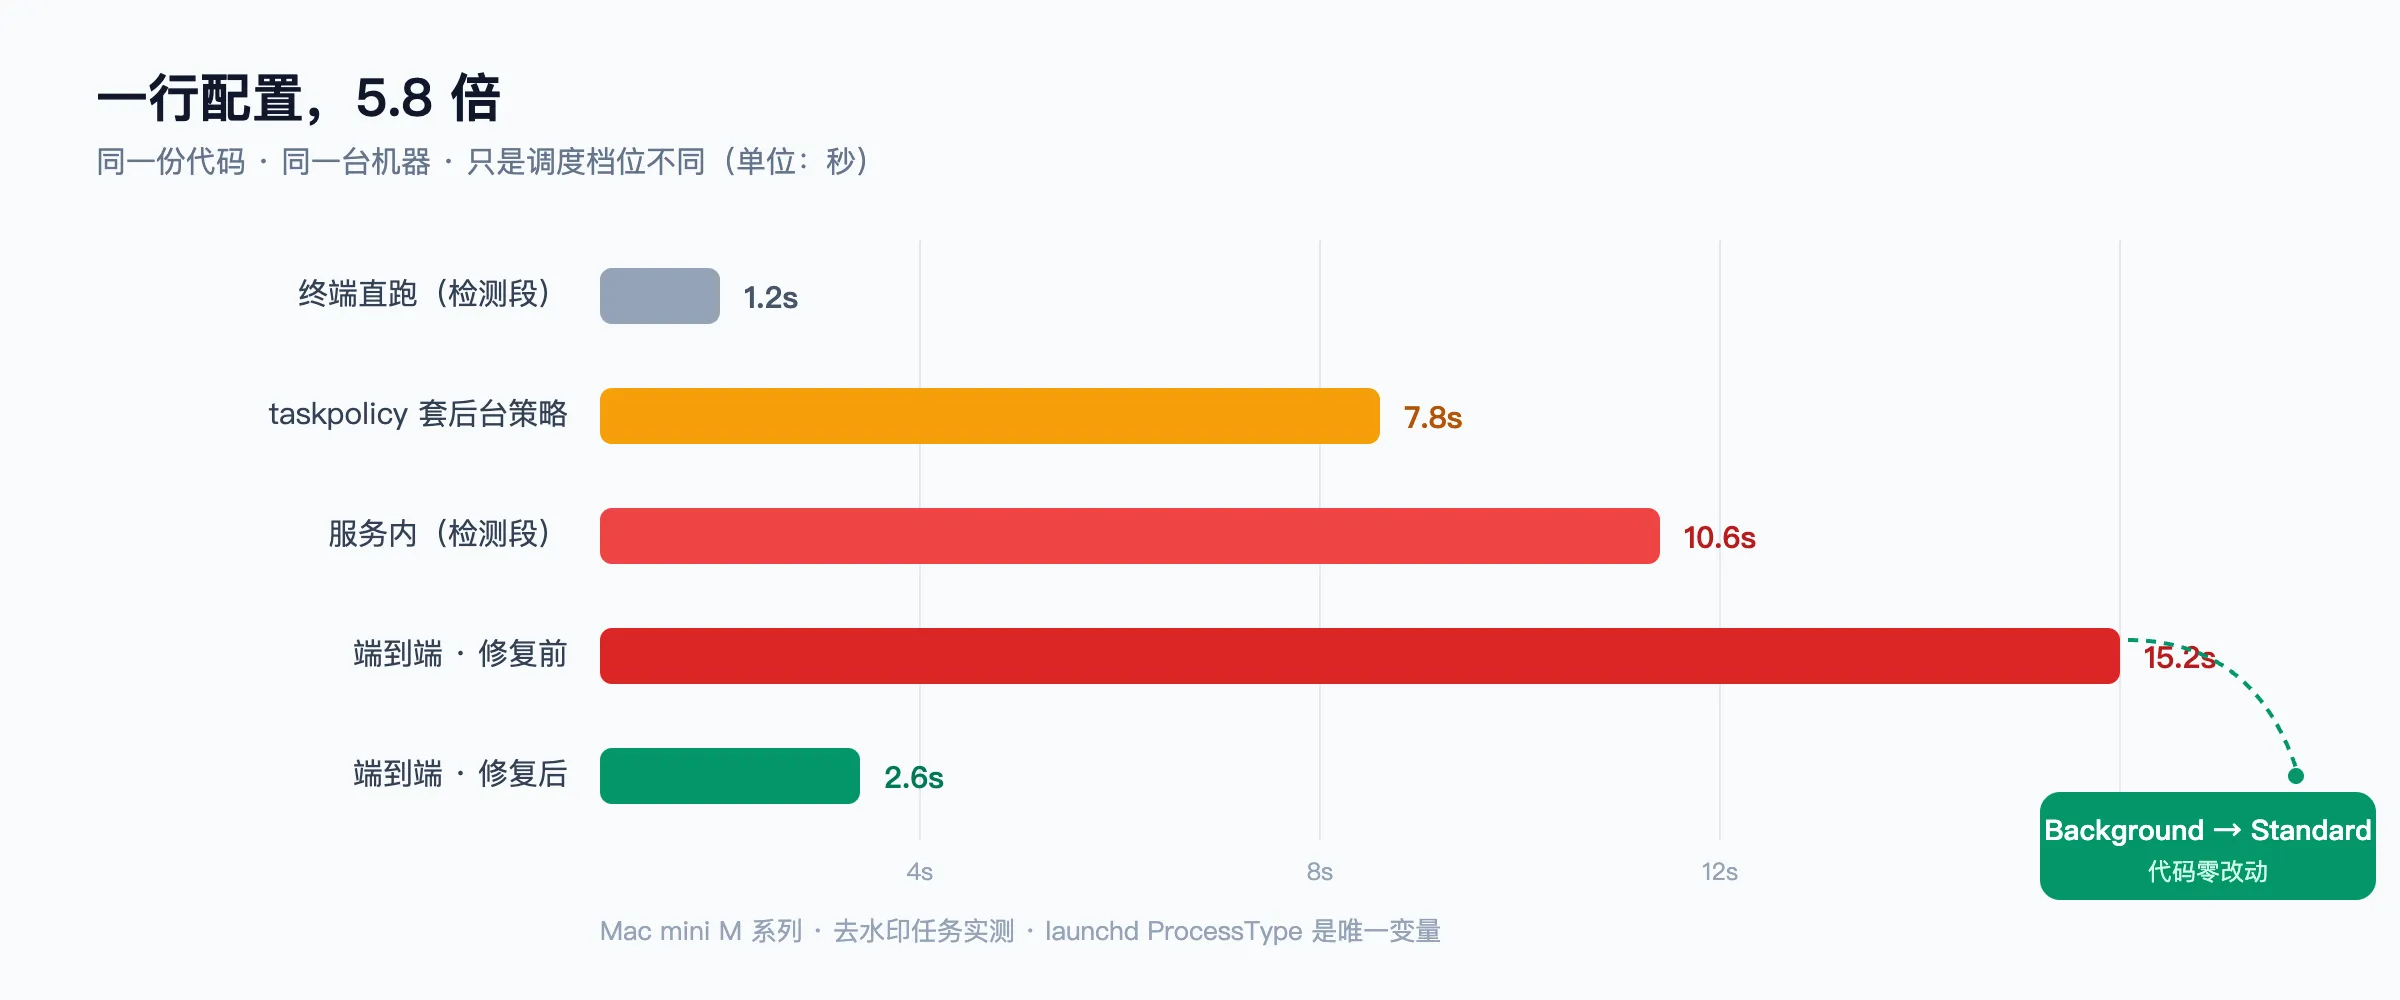
第一组数据在终端里直接跑:YOLO 检测 1227 毫秒,OCR 定位 362 毫秒,轻量模型 16 毫秒,合计一点六秒左右。
第二组数据,同一份代码、同一组模型、同一台机器,从服务进程里走一遍:光检测段就从 1.2 秒膨胀到 10.6 秒。
代码没变,模型没变,机器没变,唯一不一样的,是跑代码的进程。
看起来,问题出在这个服务进程跑起来的方式上。
三、launchd 里的 Background
我的服务在 macOS 上是通过 launchd 守护进程启动的,配置写在 .plist 文件里。翻到进程调度相关的配置项,看到了这一行,开始怀疑这个配置。
ProcessType = Background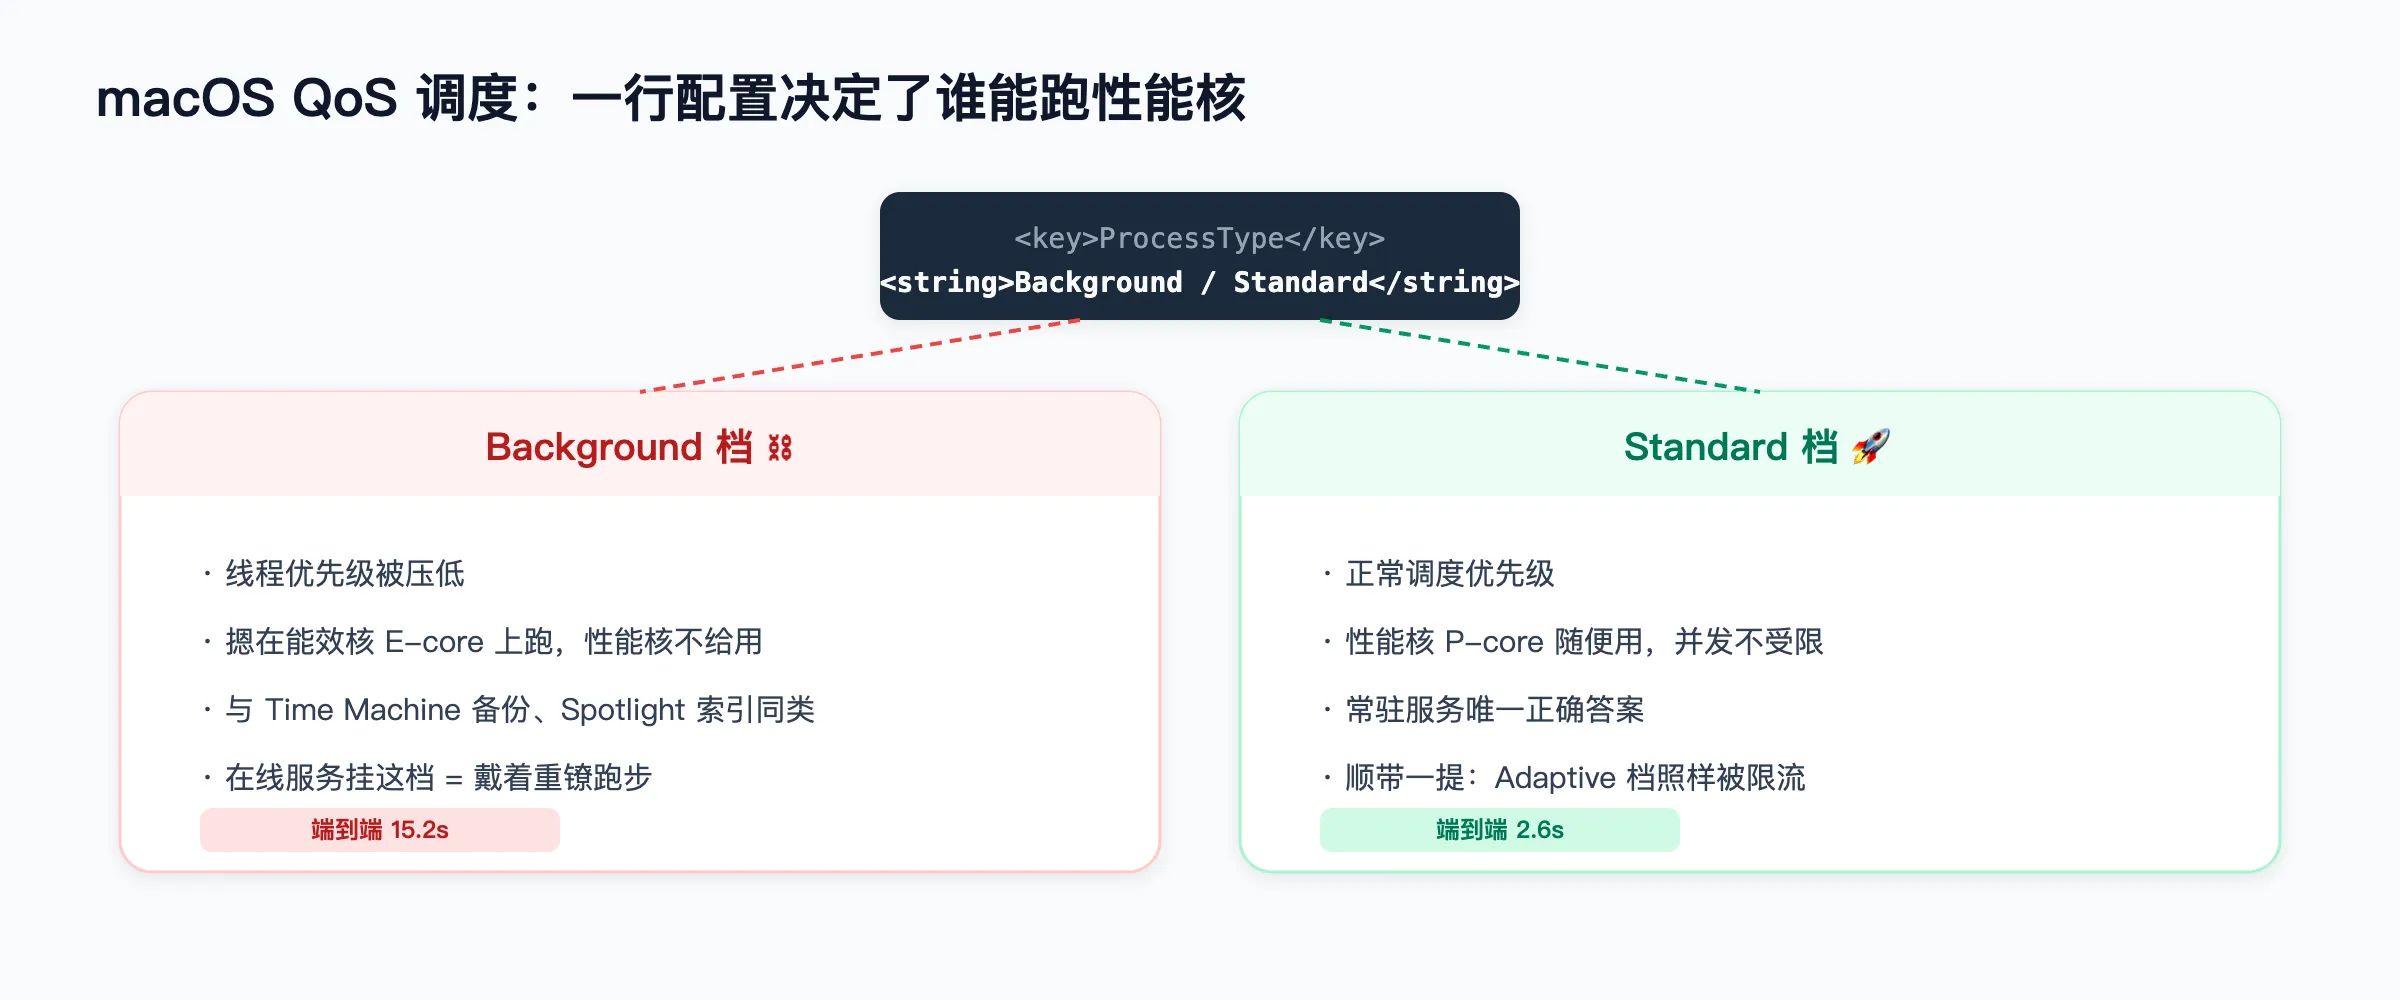
这里得说说 macOS 的调度机制。macOS有一套很细的电源与进程调度策略,进程被标成 Background 级别时,系统把它归到跟 Time Machine 备份、Spotlight 建索引一类的「不着急的活」里:线程优先级被压低,M 芯片上被安排到能效核运行,性能核用不上,线程并发数也受限。
一个对外提供服务的在线进程挂在这个档位,等于全程戴着镣铐跑步,从部署第一天起就是这样,只是一直不知道。
为什么 .plist 里会写 Background?因为网上大量 launchd 教程模板就是这么写的,AI 抄的时候没注意这一行。
四、验证:taskpolicy 实锤
定位到嫌疑配置,光找到嫌疑还不算数。macOS 自带 taskpolicy 工具,能把进程临时换到别的调度策略跑。
同一个测试脚本,正常策略下跑 1.2 秒,用 taskpolicy 压到 Background 策略下跑 7.8 秒。差 6 倍多,问题实锤。
五、修复:一行配置
修复只要一行:把 .plist 里的 ProcessType 从 Background 改成 Standard,重启服务。
整个流程从 15.2 秒降到 2.6 秒,代码一行没动。困扰多日的性能问题,就这样解决了。
六、三条复盘
一,部署方式本身就影响性能。同一份代码,宿主进程的调度档位不同,性能可以差 6 倍。排查性能问题时光盯着代码和硬件,方向可能一开始就偏了。
二,网上教程的重灾区,后台服务跟着抄 Background 的不知有多少。
三,Vibecoding 时 预判、实测、追问,三步缺一不可。AI 的判断偏保守,这次如果不是云端实测反而快,我不会回头质疑本地的 15 秒。 不追问,就永远不知道慢的不是代码,是一行配置。
你遇到过「代码没变、性能玄学」的问题吗?评论区聊聊你的排查经历。
编辑本页